论文原文与图表
Deep learning-based prediction of piled-up status and payload distribution of bulk material
散料堆积状态与载荷分布的深度学习预测
论文从车厢料堆图像估计当前质量与重心,再结合本次净卸料质量和卸料坐标预测下一次卸料后的载荷分布。
论文摘要
论文提出基于图像的散料堆积状态与载荷分布预测方法。两阶段分类—回归CNN从当前料堆图像估计质量和重心;当前状态、本次净卸料质量及卸料坐标组成六维输入,BPNN输出下一状态的四角载荷。双机器人缩比实验共获得8,840组有效数据。最终模型最大预测误差约0.19 kg,约占总质量3.17%;误差分布的Cauchy拟合参数为x₀=−0.00043、γ=0.01986。
- Deep learning
- Bulk material
- Piled-up status and payload distribution
下一次卸料位置需要结合当前料堆状态和本次卸料动作
矿用运输车辆通常需要5–7次卸料才能装满,车厢内散料分布在每次卸料后发生变化。论文将质量和重心描述为堆积状态与载荷分布PSPD。
方法使用车厢上方相机采集料堆表面图像,并把当前状态、本次净卸料质量和卸料坐标连接到下一状态预测。
图像预处理、两阶段CNN和BPNN组成三部分预测框架
Part I对图像执行ROI提取、背景去除和灰度化,对质量及坐标测量执行去零漂、滤波和平均。
Part II使用CNN估计当前料堆的总质量与重心坐标;Part III将六维状态与动作输入映射为卸料后的四角载荷m₁–m₄。
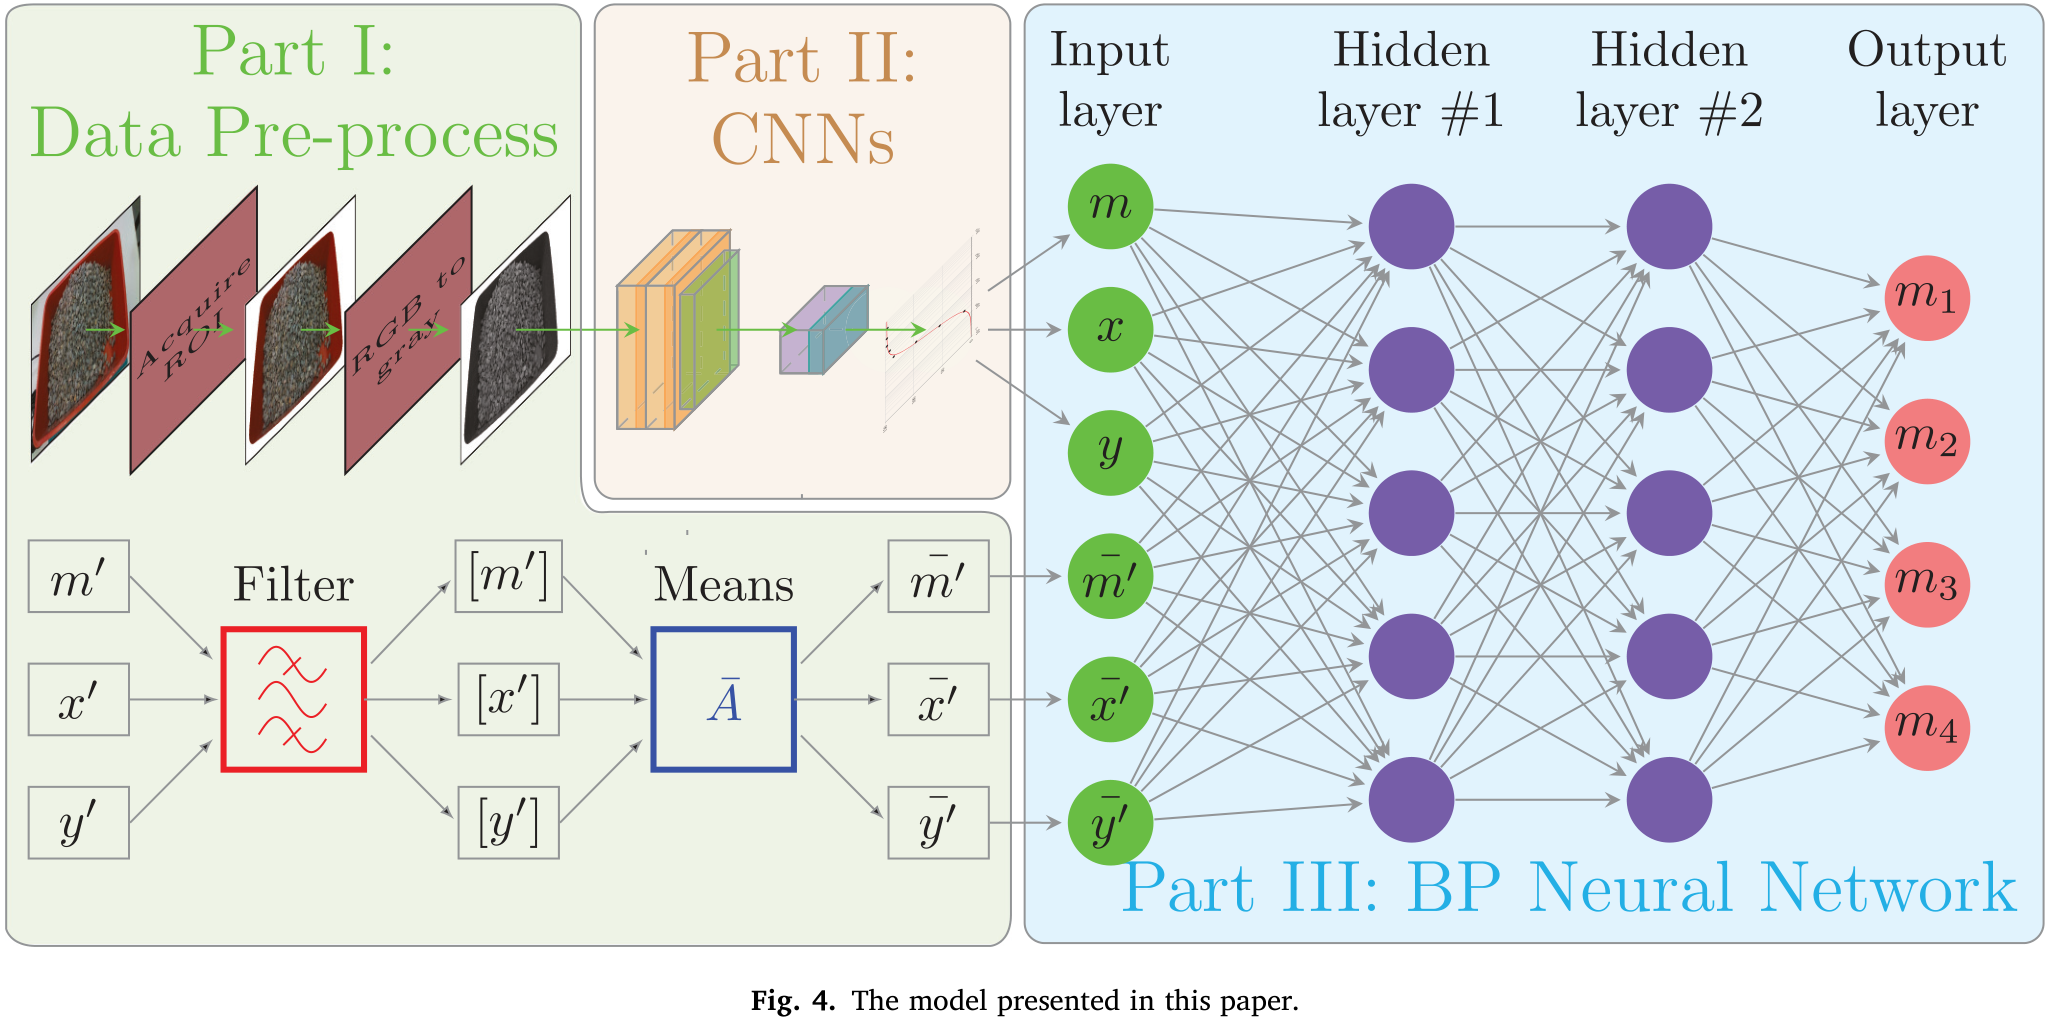
论文提出的总体模型。
The model presented in this paper.
查看高清原图 ↗图像与传感器数据分别完成净化和稳定化处理
车厢、散料和背景具有可识别色差,论文使用梯形掩膜提取ROI并删除区域外背景,再按0.30R+0.59G+0.11B转换灰度。
四角载荷数据在每轮卸料前消除零漂,卸料后经过滤波和平均;相邻两次测量之差用于确定本次净卸料质量。
先按质量区间分类,再用类别对应网络回归质量和重心
图像按车厢内材料质量划分为六个区间:(0,1]、(1,2]、(2,3]、(3,4]、(4,5]和(5,7] kg。VGG19基础分类器经修改后包含47层。
每个类别分别训练质量回归网络和重心坐标回归网络。回归器以VGG19为基础,包含41层;质量与坐标使用两套独立网络。分类器最终Accuracy为97.26%,Loss为0.082。
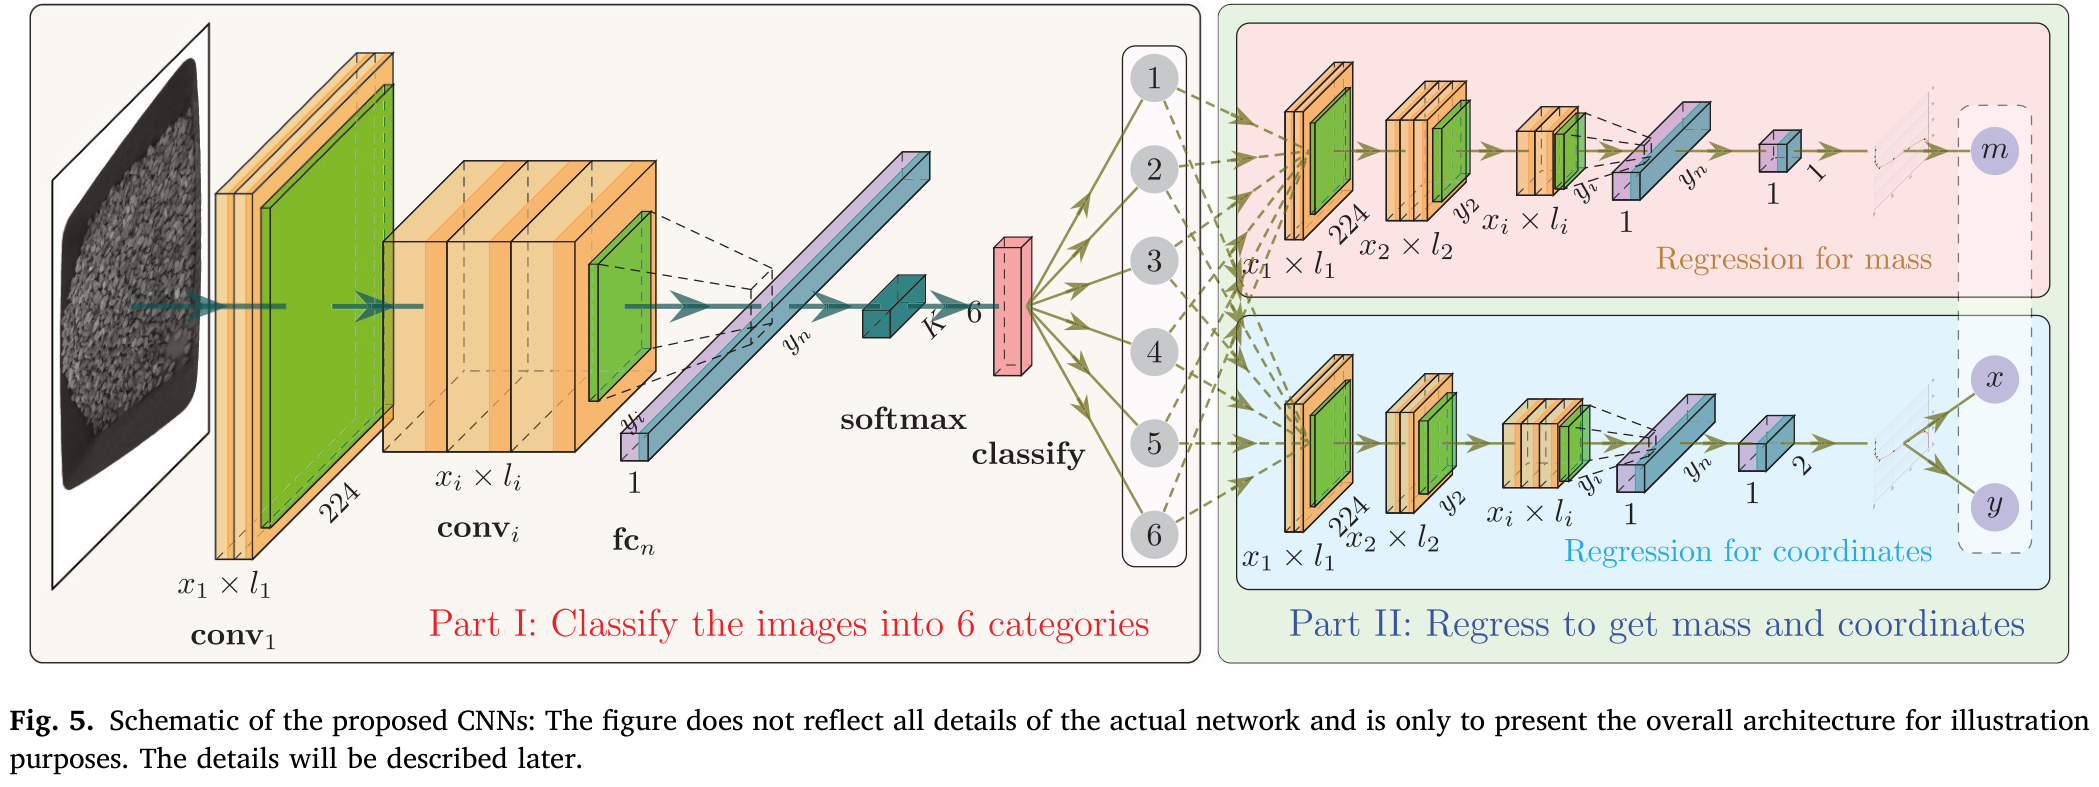
所提出CNN的总体结构示意:图中省略了实际网络的部分细节,后文给出具体结构。
Schematic of the proposed CNNs: The figure does not reflect all details of the actual network and is only to present the overall architecture for illustration purposes. The details will be described later.
查看高清原图 ↗BPNN采用6输入、4输出预测下一状态四角载荷
六维输入由当前总质量m、当前重心x和y、本次净卸料质量m′、卸料位置x′和y′组成。
BPNN输出红色车厢模型四角载荷m₁、m₂、m₃、m₄;四角数据用于计算卸料后总质量和重心坐标。
两台KUKA机器人分别执行卸料和图像采集
一台LBR iiwa 14 R820机器人携带3D打印塑料铲斗,从黑箱中的约10 mm不规则石灰石取料并向红色车厢模型卸料。
另一台机器人携带USB相机,从车厢上方采集料堆表面RGB图像;红箱四角安装载荷传感器,数据记录器与相机通过USB连接,机器人通过TCP/IP连接。
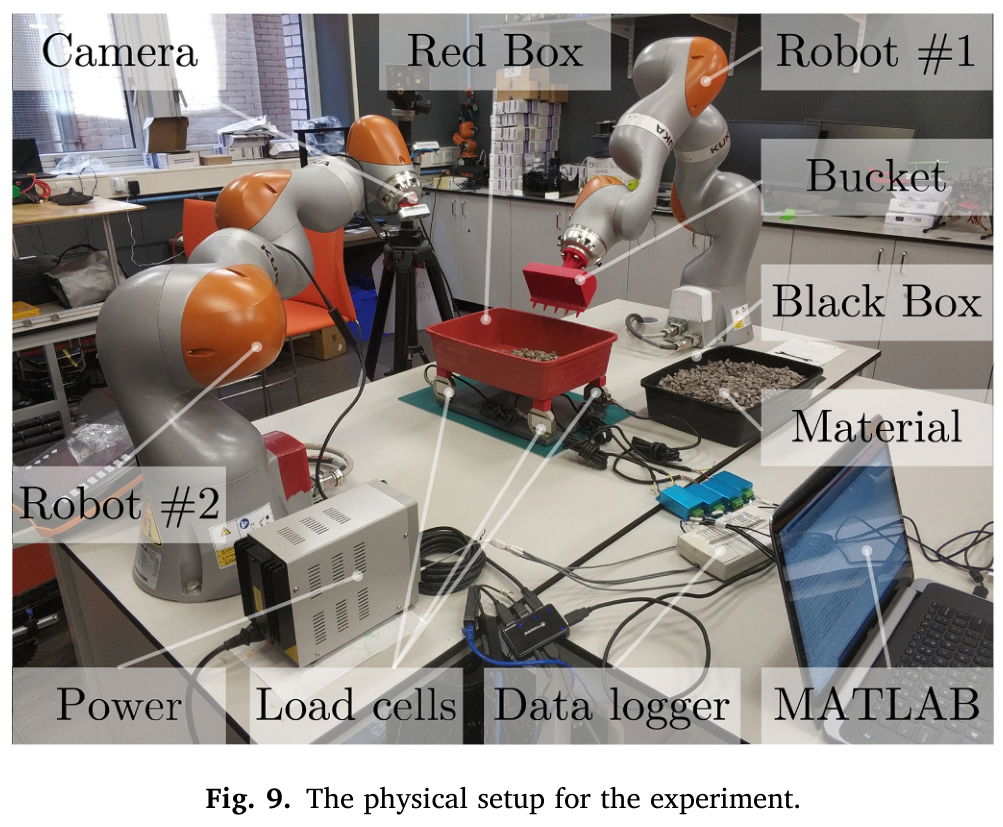
实验物理平台。
The physical setup for the experiment.
查看高清原图 ↗9个预设卸料位置共形成8,840组有效配对数据
实验在九个预设卸料位置分别执行约1,000次试验,总计获得8,840组有效数据。每组包含图像及对应传感器数据。
模型输入记录包括当前料堆图像、本次净卸料质量和卸料坐标;标签为卸料后的四角载荷。材料单次质量近似服从N(0.4379, 0.06866)。
四个BPNN输出的预测值与目标值接近线性一致
Fig.17分别展示m₁、m₂、m₃、m₄的预测值与目标值。四幅图拟合斜率范围为0.99127–0.99414,截距范围为0.00302–0.00674。
最终误差的Cauchy拟合位置参数x₀为−0.00043,尺度参数γ为0.01986。
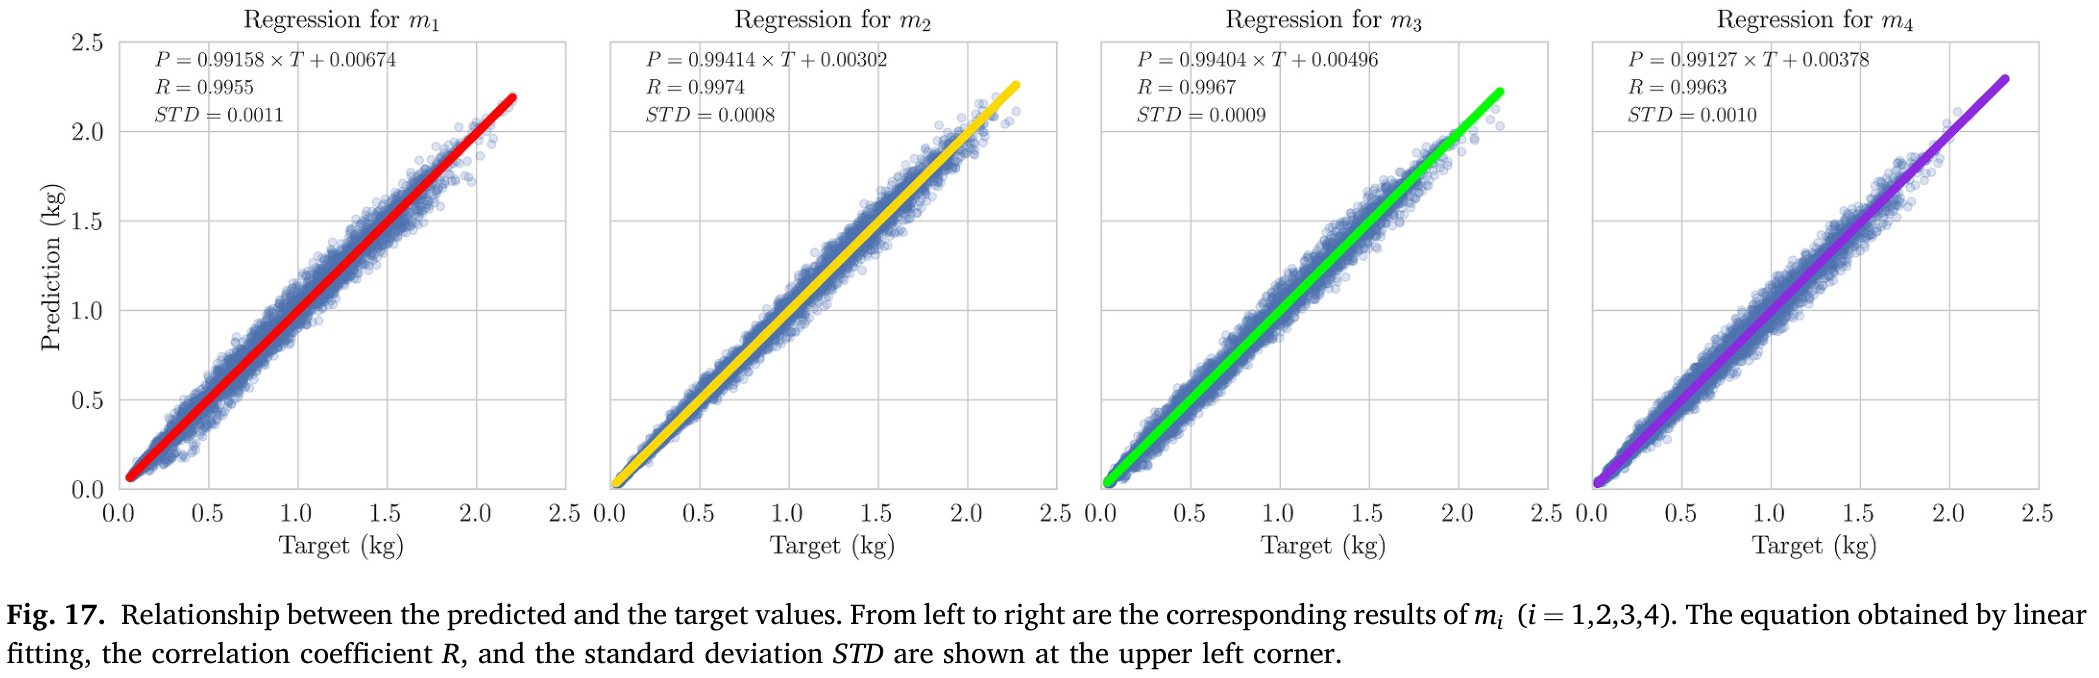
预测值与目标值关系,从左至右分别为mᵢ(i=1、2、3、4)的结果;左上角标出线性拟合方程、相关系数R和标准差STD。
Relationship between the predicted and the target values. From left to right are the corresponding results of mi (i = 1,2,3,4). The equation obtained by linear fitting, the correlation coefficient R, and the standard deviation STD are shown at the upper left corner.
查看高清原图 ↗最终模型最大误差约0.19 kg,单次预测耗时104.8 ms
Table 5的CNN回归比较中,VGG19的RMSE为0.0800、Loss为0.00321。该结果对应当前状态CNN回归环节。
最终PSPD预测模型在Table 6中的最大误差为0.19205 kg,最小误差为−0.18929 kg,单次预测耗时104.8 ms;论文将绝对极值概括为约0.19 kg、约占总质量3.17%。
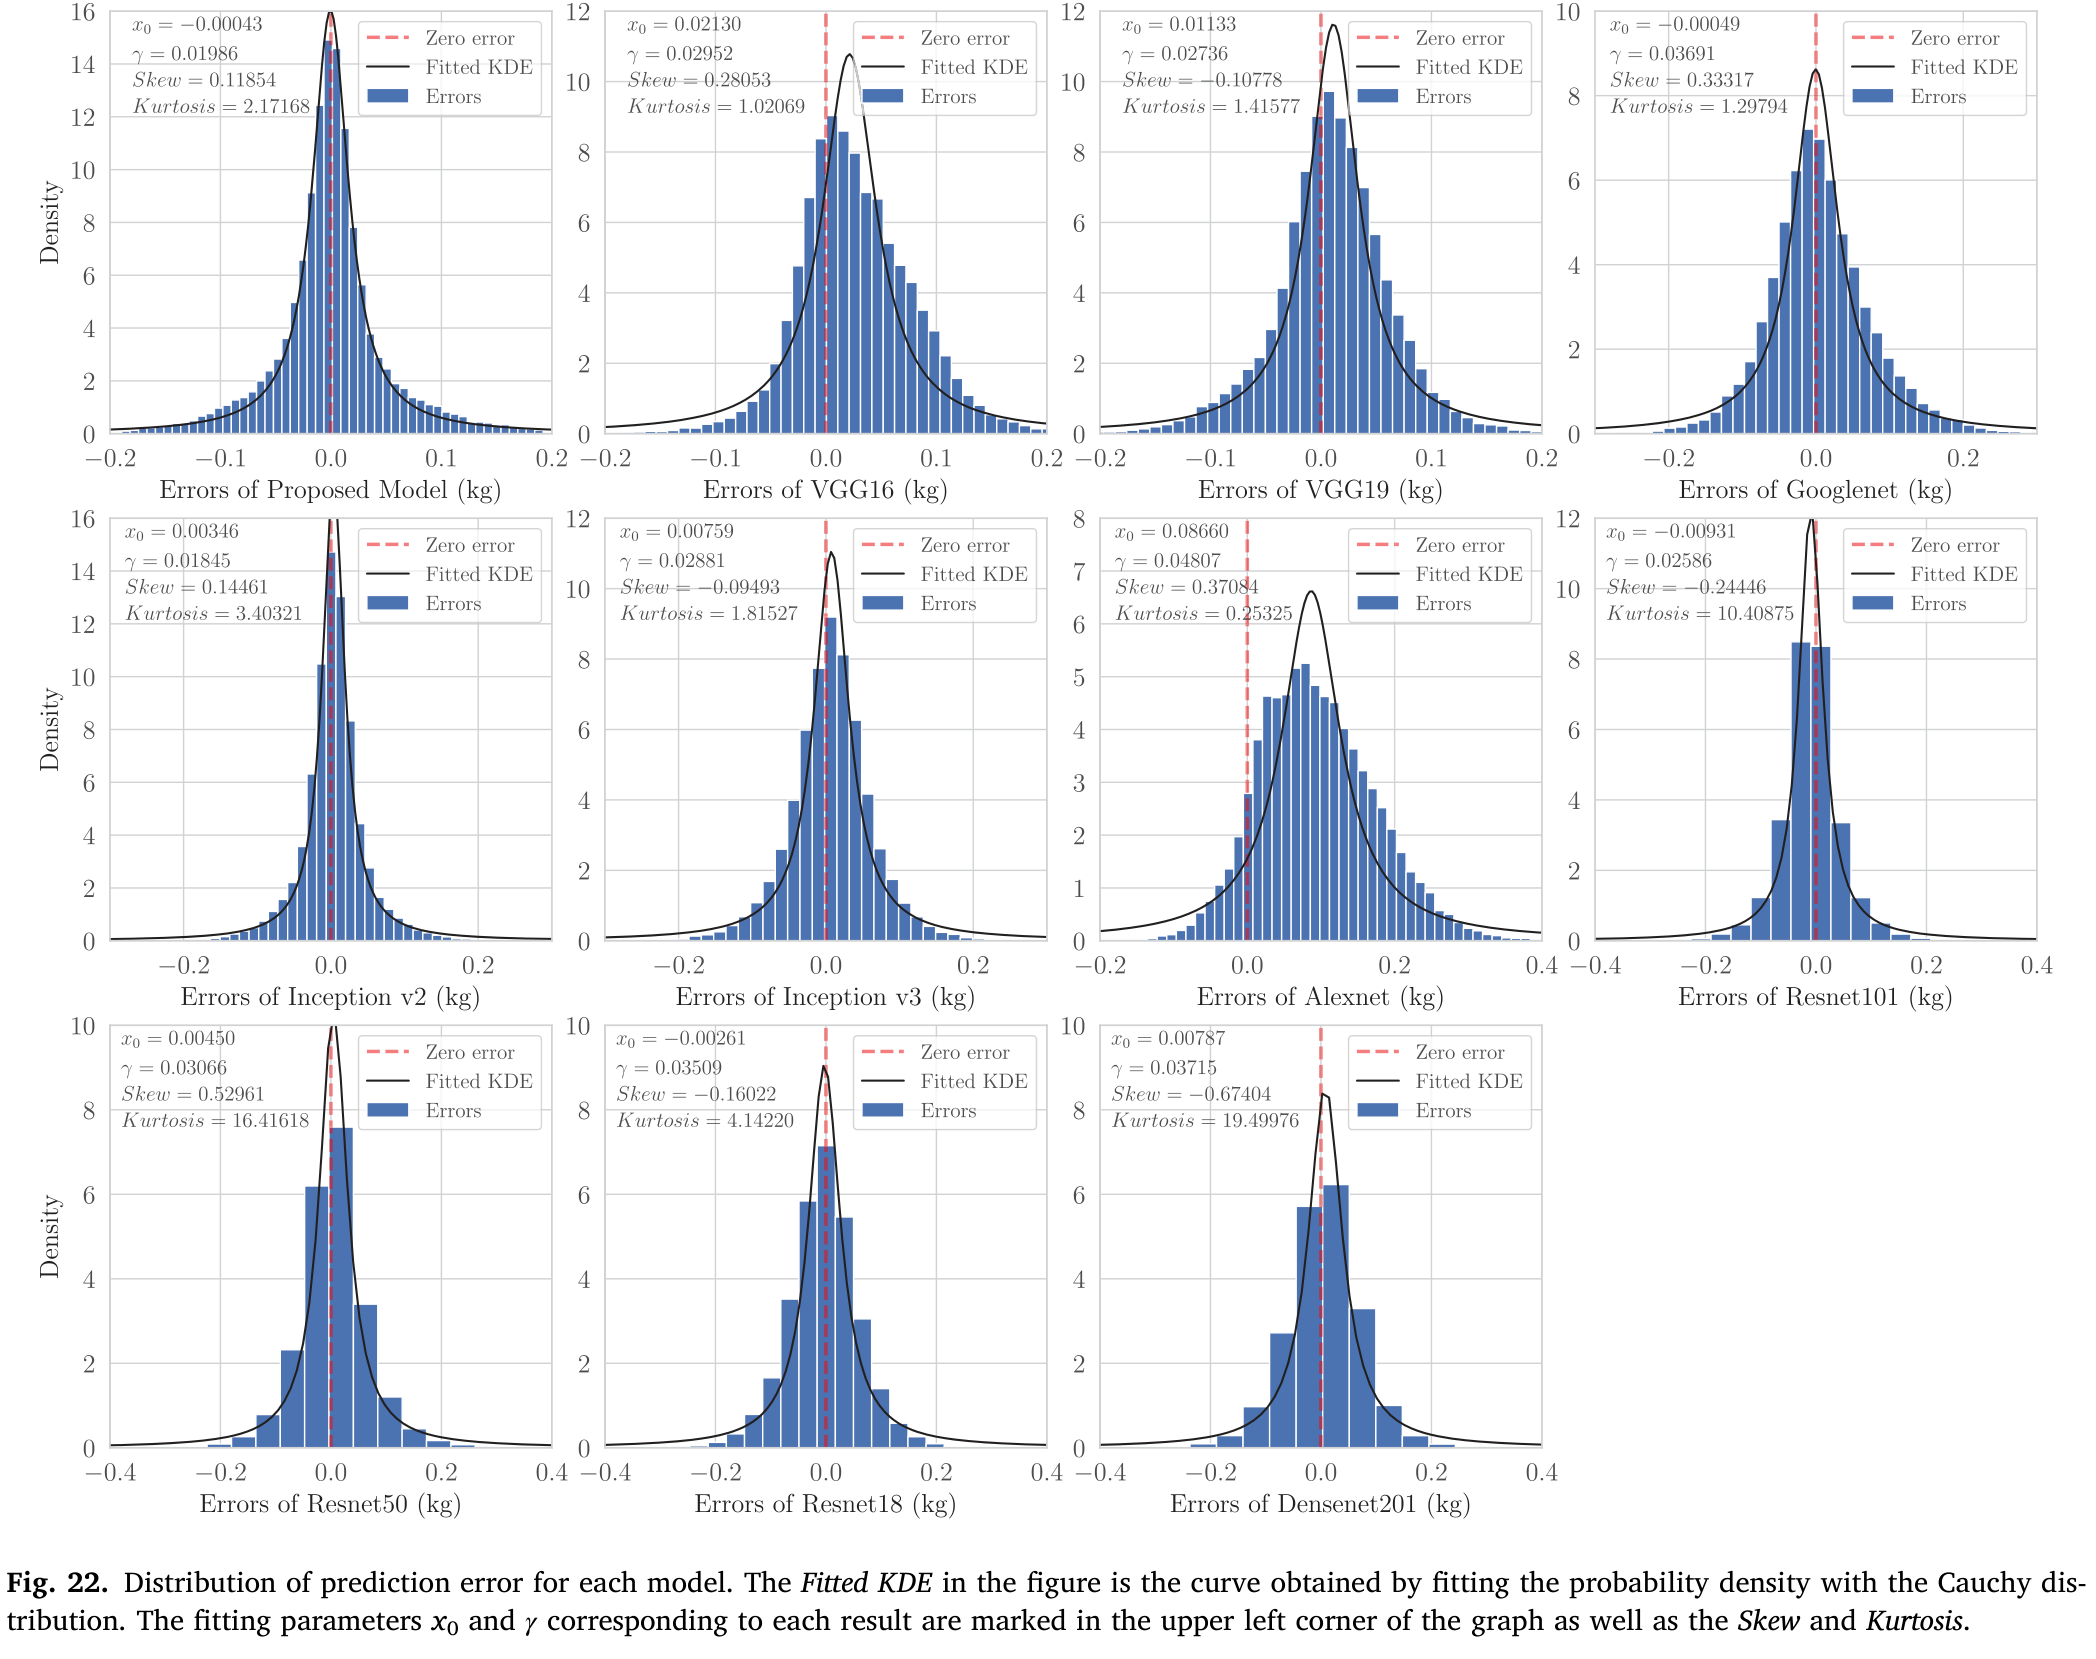
各模型预测误差分布。Fitted KDE为Cauchy分布拟合曲线,左上角标出x₀、γ、偏度和峰度。
Distribution of prediction error for each model. The Fitted KDE in the figure is the curve obtained by fitting the probability density with the Cauchy distribution. The fitting parameters x0 and γ corresponding to each result are marked in the upper left corner of the graph as well as the Skew and Kurtosis.
查看高清原图 ↗实验验证在可控光照的双机器人缩比平台完成
实验使用同一种约10 mm石灰石、固定红箱几何和可控光照。论文将真实环境中的照明变化、粉尘、振动、数据域差异及混合物料列为后续研究问题。
从实验室数据迁移到实际车辆需要重新采集现场标注数据,并针对图像退化和数据域差异进行处理。
第二层阅读
需要更快地把握方法链和核心机制?
AI简报不会替代上方的论文原文导读;它只在您主动打开时加载。引用本文
以下格式根据论文正式题录生成;使用前请按目标期刊或机构规范复核。
YAO Z, HUANG Q, JI Z, LI X, BI Q. Deep learning-based prediction of piled-up status and payload distribution of bulk material[J]. Automation in Construction, 2021, 121: 103424. DOI:10.1016/j.autcon.2020.103424.
Yao, Z., Huang, Q., Ji, Z., Li, X., & Bi, Q. (2021). Deep learning-based prediction of piled-up status and payload distribution of bulk material. Automation in Construction, 121, 103424. https://doi.org/10.1016/j.autcon.2020.103424
Z. Yao, Q. Huang, Z. Ji, X. Li, and Q. Bi, “Deep learning-based prediction of piled-up status and payload distribution of bulk material,” Automation in Construction, vol. 121, Art. no. 103424, 2021, doi: 10.1016/j.autcon.2020.103424.